概述
当Pytorch显存溢出时,通常会抛出如下的错误:
torch.OutOfMemoryError: CUDA out of memory. Tried to allocate xxxx MB. GPU 0 has a total capacity of xxxx GiB of which xxxx bytes is free. Of the allocated memory xxxx GiB is allocated by PyTorch, and xxxx MB is reserved by PyTorch but unallocated. If reserved but unallocated memory is large try setting PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True to avoid fragmentation. See documentation for Memory Management (https://pytorch.org/docs/stable/notes/cuda.html#environment-variables)
阅读本文,你将理解下面这句报错中的显存大小
GPU 0 has a total capacity of xxxx GiB of which xxxx bytes is free
和下面这句报错中的显存大小的关系
Of the allocated memory xxxx GiB is allocated by PyTorch, and xxxx MB is reserved by PyTorch but unallocated.
以及为什么有时PyTorch reserved的显存大小大于要申请的显存大小,PyTorch仍然无法为你成功申请显存。
为什么要有CachingAllocator
在 GPU 编程中,GPU 是异步执行的。然而,cudaMalloc 和 cudaFree 通常被视为同步操作。调用这些接口,往往意味着一些性能开销,原因主要有两点:
- 高延迟:调用一次 cudaMalloc 需要操作系统内核与GPU驱动进行复杂的交互,这种系统级调用的耗时远高于CPU上的 malloc。
- 阻塞:频繁的申请与释放会导致GPU流产生不必要的同步,迫使计算单元等待内存管理完成,从而引发严重的性能抖动。
为了解决原生CUDA内存管理的性能问题,PyTorch实现了自定义的显存分配器 CachingAllocator。其核心设计思想是空间换时间:从GPU驱动层一次性申请一大块连续的显存空间作为显存池,后续模型训练、张量运算所需的显存,均由 CachingAllocator从显存池中直接分配,而非直接调用cudaMalloc向驱动层申请;当张量被释放时,显存也不会立即通过cudaFree归还给 GPU 驱动,而是被CachingAllocator回收至显存池,标记为未分配但已保留的状态,供后续新的显存申请复用。
需要明确的是,CachingAllocator的管理范围仅针对PyTorch 进程内的 CUDA显存,如CuDNN、NCCL的部分显存占用并不会被CachingAllocator所管理和统计。
理解报错中的核心显存指标
我们先明确报错中三个核心显存指标的定义,再结合分层模型解释其关联关系:
1. GPU驱动层:Total Capacity & Free Bytes
GPU 0 has a total capacity of xxxx GiB of which xxxx bytes is free
这组数值是GPU驱动层(NVIDIA Driver) 的全局统计结果,反映的是整个 GPU 设备的显存使用状态:
- Total Capacity、:GPU的物理显存总容量(如 16GiB、24GiB),是硬件层面的固定值;
- Free Bytes:GPU驱动层当前未被任何进程占用的显存空间,即 “真正的空闲显存”—— 这部分显存尚未被包括PyTorch在内的任何CUDA进程申请,GPU驱动可直接分配给任意进程。
这一指标可以通过 nvidia-smi 命令直接查看,对应 Free 列的数值,是操作系统层面的显存全局视图。
2. PyTorch层:Allocated by PyTorch & Reserved but Unallocated
Of the allocated memory xxxx GiB is allocated by PyTorch, and xxxx MB is reserved by PyTorch but unallocated.
这组数值是PyTorch CachingAllocator内部的统计结果,仅反映 PyTorch 进程自身的显存管理状态,其中 allocated memory 是 PyTorch 从 GPU 驱动层已申请的总显存,该部分显存已被 GPU 驱动标记为 “被 PyTorch 进程占用”,不再计入驱动层的 Free Bytes,其内部又分为两个子状态:
- Allocated by PyTorch:缓存池中已分配给实际张量/计算的显存,即PyTorch当前正在使用的显存(如模型参数、输入输出张量、中间计算张量);
- Reserved but unallocated:缓存池中未分配但已保留的显存,这部分显存是PyTorch之前申请后回收的,既没有被 PyTorch 当前使用,也没有归还给GPU驱动,处于“闲置等待复用”的状态。
3. 显存指标的关系
为了更清晰的理解,我们总结下各显存指标的关联:
GPU总显存 = 驱动层已占用显存 + 驱动层空闲显存(Free Bytes)
驱动层已占用显存 = PyTorch已申请总显存(Allocated memory) + 其他进程CUDA显存占用
PyTorch已申请总显存 = 已分配显存(Allocated by PyTorch) + 保留未分配显存(Reserved but unallocated)
简单来说:PyTorch 的 “保留未分配显存”,在 GPU 驱动层看来是 “已被占用”,但在 PyTorch 内部看来是 “可复用的空闲显存”。
从Block的分配、切分、归还,看显存碎片的产生过程
一个碰到显存溢出时最常见的疑惑:为什么PyTorch reserved但空闲的内存大于要申请的内存,但依然抛出CUDA out of memory错误。这通常是由于Allocator中存在大量的显存碎片。
其根本原因是:PyTorch的显存申请优先级是“复用Caching Allocator保留但未分配显存”,而非直接向GPU驱动申请新的显存,而Caching Allocator申请的显存池里的连续空闲显存不足以满足本次申请,最终导致申请失败。
CachingAllocator对显存池的管理,本质上是对不同大小的显存块(Block)的管理:显存池初始化或扩容时,从GPU驱动层申请的是大块的连续物理显存,CachingAllocator会将其划分为若干个规整的Block;后续所有张量的显存申请,都是从这些Block中分配匹配的空间;张量释放时,显存会以块为单位归还给缓存池。
显存碎片的产生,是Block的“分配-切分” 与 “归还-闲置” 两个过程叠加后,打破了显存池原有连续性的结果。接下来从初始状态、分配切分、随机归还三个阶段,举个例子理解碎片是如何产生的。
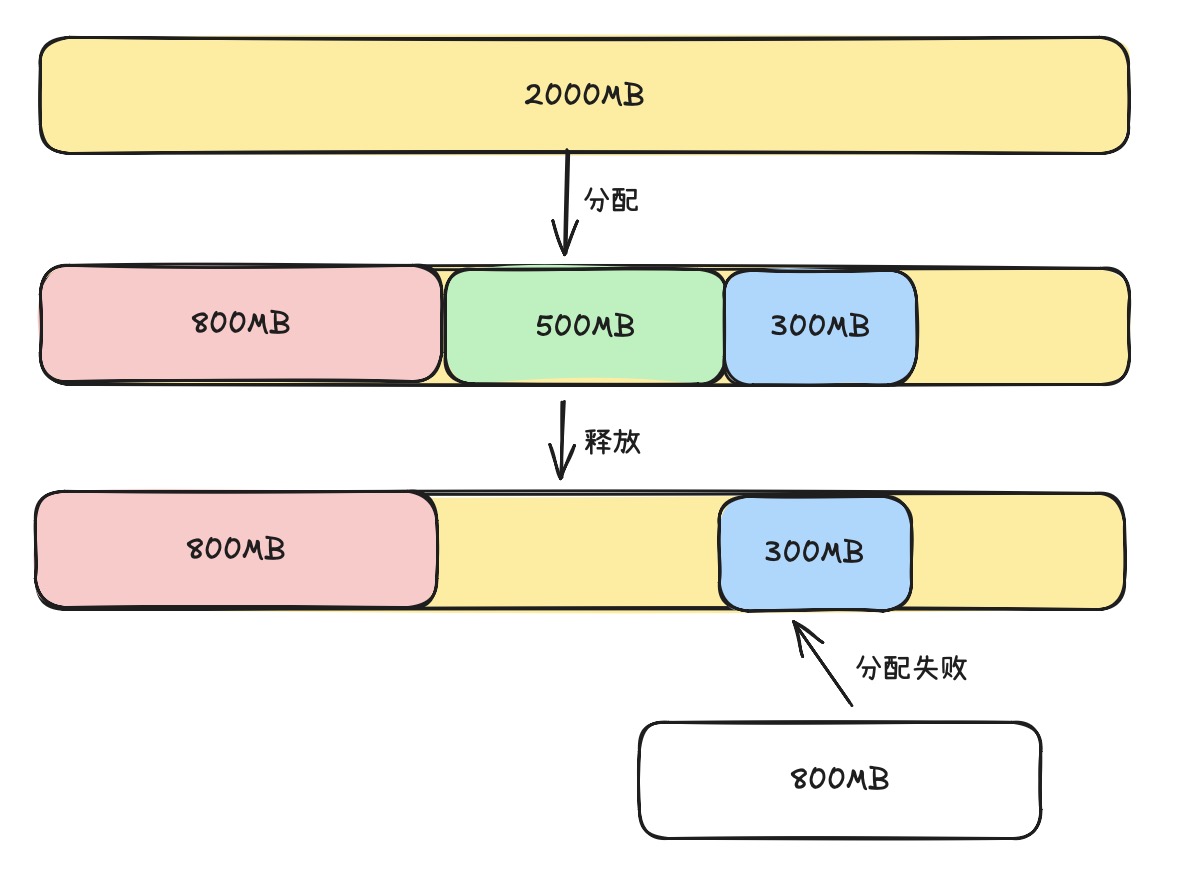
阶段1:Block初始状态
假设PyTorch刚启动,CachingAllocator向GPU驱动层申请了一块2000MB的连续显存作为初始显存池,此时缓存池内只有1个2000MB的连续空闲大Block,无任何碎片,所有显存空间都是连续可分配的。
这一阶段是缓存池的理想状态,任意小于2000MB的显存申请,都能直接从这个大Block中分配,不会出现碎片问题。
阶段2:分配与切分
PyTorch的张量显存申请是按需发起的,每次申请显存的大小不是固定的。CachingAllocator的分配策略是找最小的能容纳申请的空闲Block(减少对大Block的浪费),若找到的Block大小略大于申请的显存,为了提升显存利用率,CachingAllocator会对该Block进行切分:
- 切出与申请大小完全匹配的子Block,分配给当前张量使用;
- 剩余的部分形成新的小空闲Block,保留在缓存池中继续等待复用。
举个例子🌰:基于2000MB的初始连续Block,依次发起三次显存申请:
- 申请800MB:找到2000MB的大Block,切分后800MB成为已分配Block,剩余1200MB成为新的连续空闲Block;
- 申请500MB:找到1200MB的空闲Block,切分后500MB成为已分配Block,剩余700MB成为新的连续空闲Block;
- 申请300MB:找到700MB的空闲Block,切分后300MB成为已分配Block,剩余400MB成为新的连续空闲Block。
此时缓存池的状态:
- 已分配Block:800MB、500MB、300MB(总1600MB,连续分布);
- 空闲Block:400MB(连续,无碎片);
- 整体仍保持连续,只是大Block被切分为若干个已分配块+一个小空闲块。
单纯的Block切分不会产生碎片,因为切分后的已分配块和空闲块依然是连续分布的,此时缓存池内的空闲空间还是一个完整的连续Block。
阶段3:归还与闲置
训练过程中,不同张量的生命周期是不同的,这就意味着并非所有张量都会按照分配时的顺序进行显存的释放。
当张量被释放时,其占用的已分配Block会被标记为空闲,归还给CachingAllocator,但这些归还的空闲小Block可能会散落在原本连续的已分配Block之间,将原本完整的连续显存空间分割成多个不连续的空闲Block。
举个例子🌰:基于阶段2的状态,500MB的显存生命周期结束,对应的Block被标记为空闲,此时这个2000MB的Block的总空闲显存大小是900MB。但是,如果此时尝试申请一个500MB-900MB的显存,会因为无法获得连续空间而失败。
如果此时恰好没有其他空闲Block,CachingAllocator会尝试free所有空闲的块,但这个2000MB的块因为被部分占据,无法释放,就会导致OOM。这时可能就会看到上面的报错:
Tried to allocate 800 MB. Of the allocated memory 2000 MB is allocated by PyTorch, and 900 MB is reserved by PyTorch but unallocated.
在训练过程中,在已有碎片的基础上,新的申请会继续切分仅存的连续空闲Block,新的释放会继续在已分配Block之间插入新的空闲小Block,最终的结果是显存碎片会越来越多。
总结
理解这三个问题:
- PyTorch Caching Allocator的意义?
- 为什么会爆显存?
- 为什么会有内存碎片?
是理解PyTorch内存管理机制的第一步,接下来我们会深入下去,尝试理解CachingAllocator每一块的逻辑。