前言
PyTorch内存管理:Caching Allocator 的第一部分是对PyTorch内存管理的基本情况的概括。这篇文章讲从代码入手,尝试理解PyTorch Caching Allocator 中最核心的数据结构:Block,以及它在实际内存分配中是如何被管理的。
Block
先通过代码看看它的定义:
struct Block {
  c10::DeviceIndex device; // gpu
  cudaStream_t stream; // allocation stream
  stream_set stream_uses; // streams on which the block was used
  size_t size; // block size in bytes
  size_t requested_size; // memory originally requested
  BlockPool* pool{nullptr}; // owning memory pool
  void* ptr{nullptr}; // memory address
  bool allocated{false}; // in-use flag
  bool mapped{true}; // is the virtual address range this Block references
                     // backed by physical pages. Always true when
                     // expandable_segment_ is null. When false
                     // This Block will be aligned to the segment size
                     // of its expandable_segment_.
  Block* prev{nullptr}; // prev block if split from a larger allocation
  Block* next{nullptr}; // next block if split from a larger allocation
  int event_count{0}; // number of outstanding CUDA events
  int64_t gc_count_base{0}; // get_free_blocks_call_count when Block is inserted
  std::shared_ptr<GatheredContext> context_when_allocated;
  // only set for the first block in the segment (when prev == null)
  // this records the frame information when cudaMalloc was called
  // whereas context_when_allocated records the last time we handed this
  // memory out from our cache.
  std::shared_ptr<GatheredContext> context_when_segment_allocated;

  ExpandableSegment* expandable_segment_{nullptr};
- device、size、ptr:这几个参数比较好理解,由于是内存管理,就一定需要涉及到分配的设备、分配的内存大小以及在设备上的地址;
- requested_size:分配时请求的实际大小;
- stream:代表分配时的stream,默认所有操作会在该流进行;
- stream_uses:使用多流时记录使用过的流;
- prev、next:说明Block本质是一个链表,这也是为什么可以很方便的在Block内部执行切分、重组操作;
- event_count:未完成的cuda_event计数;
还剩一些涉及到虚拟内存、可扩展段以及资源管理的描述,我们放到后文去深究。总之,这几个属性就已经决定了如何申请、释放一个block,以及存在异步冲突怎么解决。
关于stream和stream_uses这两个参数,在我文章的record_stream里做了一部分介绍,简而言之,同一个block,是不允许跨流复用的,因为GPU执行的异步特点,导致了将一个block分配给多个stream可能会导致数据竞争,从而导致不可预知的错误和后果,而stream_uses这个参数正是用于统计这些stream,并在释放时逐一检查。
关于内存分配
显存充足时的分配规则
当显存充足时,PyTorch只需要将一定的显存分配给对应的block就可以实现显存的分配,但是问题在于,一次应当划分多大的显存给一个block,能更大概率的保证它是有可能被复用的。
显然,如果按照每次分配时要求的requested_size去划分,一定会有很大一部分block无法被顺利复用,或者说,被复用后存在一定的间隙,这就会导致频繁的进行cudaMalloc和Free,与此同时带来的是巨大的性能开销;同时,分配时应当是以某个规则进行内存对齐的,否则读写效率会变差。
- Allocations are associated with a stream. Once freed, blocks can be re-allocated on the same stream, but not on any other stream.
基于这两个条件,看看PyTorch是怎么管理Block的大小的,Pytorch里有这样一段注释:
- Large (>1MB) and small allocations are stored in separate pools. Small requests are packed into 2MB buffers. Large requests will use the smallest available free block or allocate a new block using cudaMalloc.
- To reduce fragmentation, requests between 1MB and 10MB will allocate and split a 20MB block, if no free block of sufficient size is available.
- To further reduce fragmentation, blocks >= max_split_size are not allowed to be split. These oversize cached blocks will still satisfy requests within 1MB of the oversize cached block size.
PyTorch将Block的划分通过三个分界线来确定,通过1MB,10MB将内存划分三种情况:
- 0-1MB:申请一个2MB的Block;
- 1-10MB:申请一个20MB的Block;
- 大于10MB: 按需申请block;
这里的1MB, 10MB在代码中被称为
kSmallSize和kMinLargeAlloc
  static size_t get_allocation_size(size_t size) {
    if (size <= kSmallSize) {
      return kSmallBuffer;
    } else if (size < kMinLargeAlloc) {
      return kLargeBuffer;
    } else {
      return kRoundLarge * ((size + kRoundLarge - 1) / kRoundLarge);
    }
  }
当然,刚刚的代码解决了刚刚聊到的第一个问题,怎么分配能够使复用最大化。另外一个问题是,怎么进行对齐?答案是通过512B对齐。kMinBlockSize为512,小于其则向上取整到512.否则,根据config设置的切分数量,pow2向上取整到对应的数值。
  static size_t round_size(size_t size) {
    if (size < kMinBlockSize) {
      return kMinBlockSize;
    } else {
      auto divisions = CUDAAllocatorConfig::roundup_power2_divisions(size);
      if (divisions > 1 && size > (kMinBlockSize * divisions)) {
        return roundup_power2_next_division(size, divisions);
      } else {
        return kMinBlockSize * ((size + kMinBlockSize - 1) / kMinBlockSize);
      }
    }
  }
复用和显存不足的分配规则
同样参考刚刚的注释:
- The allocator attempts to find the smallest cached block that will fit the requested size. If the block is larger than the requested size, it may be split. If no block is found, the allocator will delegate to cudaMalloc.
当存在block可以复用时,优先寻找最小的block,并复用它。如果这个block依旧比要使用的显存大,那么就切分它,复用下上一篇文章的图片,尝试分配一个800MB的Block时,他会尝试复用现在已有的block,并对它进行切分,同时block的链表指针会更新。
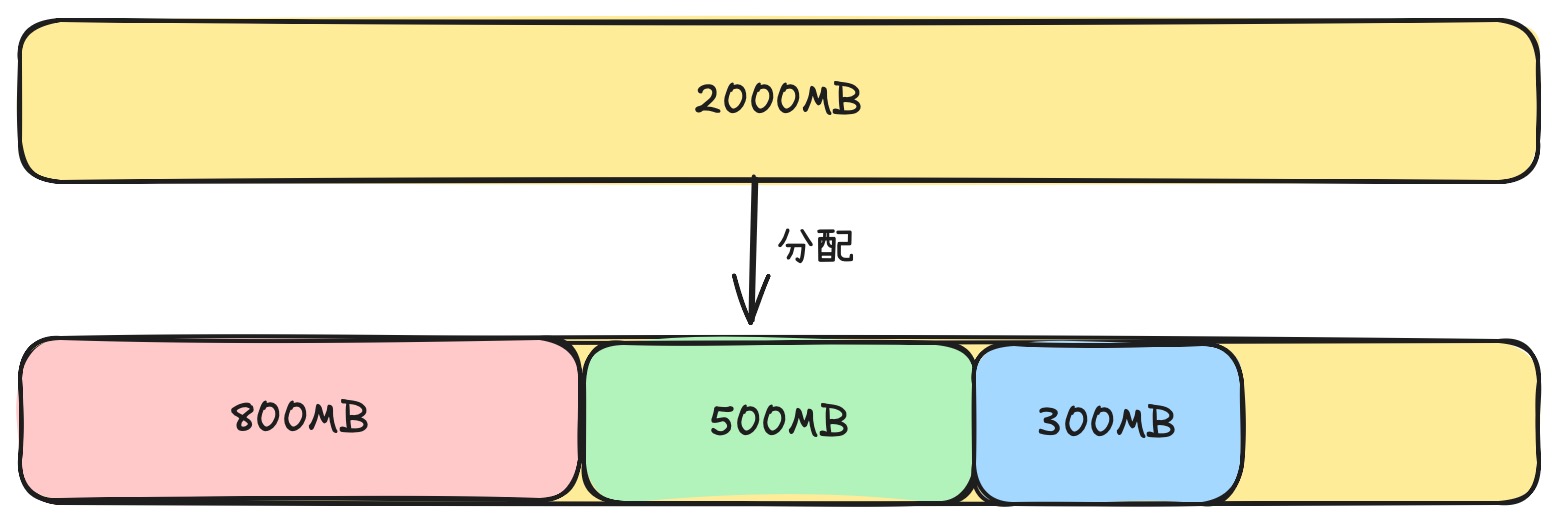
当没有block可以复用时,会逐步free一部分block,经过一系列尝试如果仍然没有空余显存,会尝试抛出OOM当error。
- If the cudaMalloc fails, the allocator will attempt to free one cached block of sufficient size that is not split and retry the allocation. If this also fails, the allocator will attempt to free all cached blocks that are not split and retry the allocation.
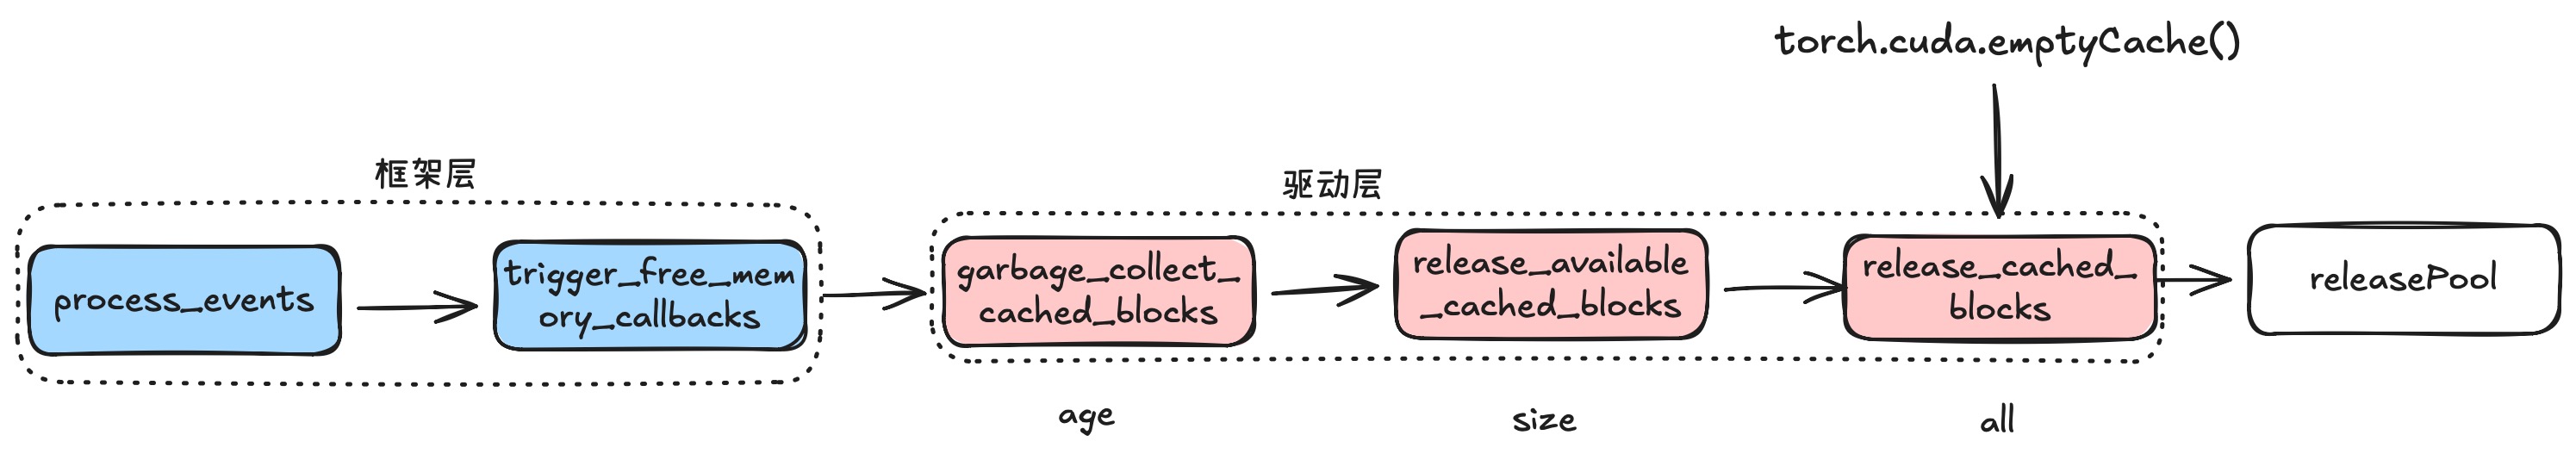
第一次尝试free,回收外部memory:
    bool block_found =
        // Search pool
        get_free_block(params)
        // Trigger callbacks and retry search
        || (trigger_free_memory_callbacks(params) && get_free_block(params));
第二次尝试free,通过GC垃圾回收释放寿命超过一点比例的block:
      if (C10_UNLIKELY(
              set_fraction &&
              CUDAAllocatorConfig::garbage_collection_threshold() > 0.0)) {
        garbage_collect_cached_blocks(context);
      }
第三次尝试free,尝试free足够大小的或者清理全部block:
block_found = alloc_block(...)  // 直接调用cudaMalloc申请新内存
    // 第一层:释放足够大小的可用缓存块,重试cudaMalloc
    || (release_available_cached_blocks(params, context) && alloc_block(...))
    // 第二层:释放所有未拆分的缓存块,重试cudaMalloc
    || (C10_LIKELY(captures_underway.empty()) && release_cached_blocks(context, {0, 0}) && alloc_block(...));
第三次尝试free,会尝试清理私有内存池的内存块,如果还无法申请,那么就会导致OOM。
当然,也可以手动执行清理,通过接口torch.cuda.empty_cache()清理所有显存,对应的就是这里的release_cached_blocks。整套流程尝试很多次free,并获取可用的block,但其实也很好理解:首先申请自己管理的内存,其次申请驱动管理的内存,最后从其他内存池申请。相当于要去买东西但零钱不够支付,首先肯定会翻一下自己的钱包,如果还不够,会尝试向老妈借钱,最后的最后才会去考虑完全与自己无关的资金。
关于内存释放
Tensor与Block生命周期
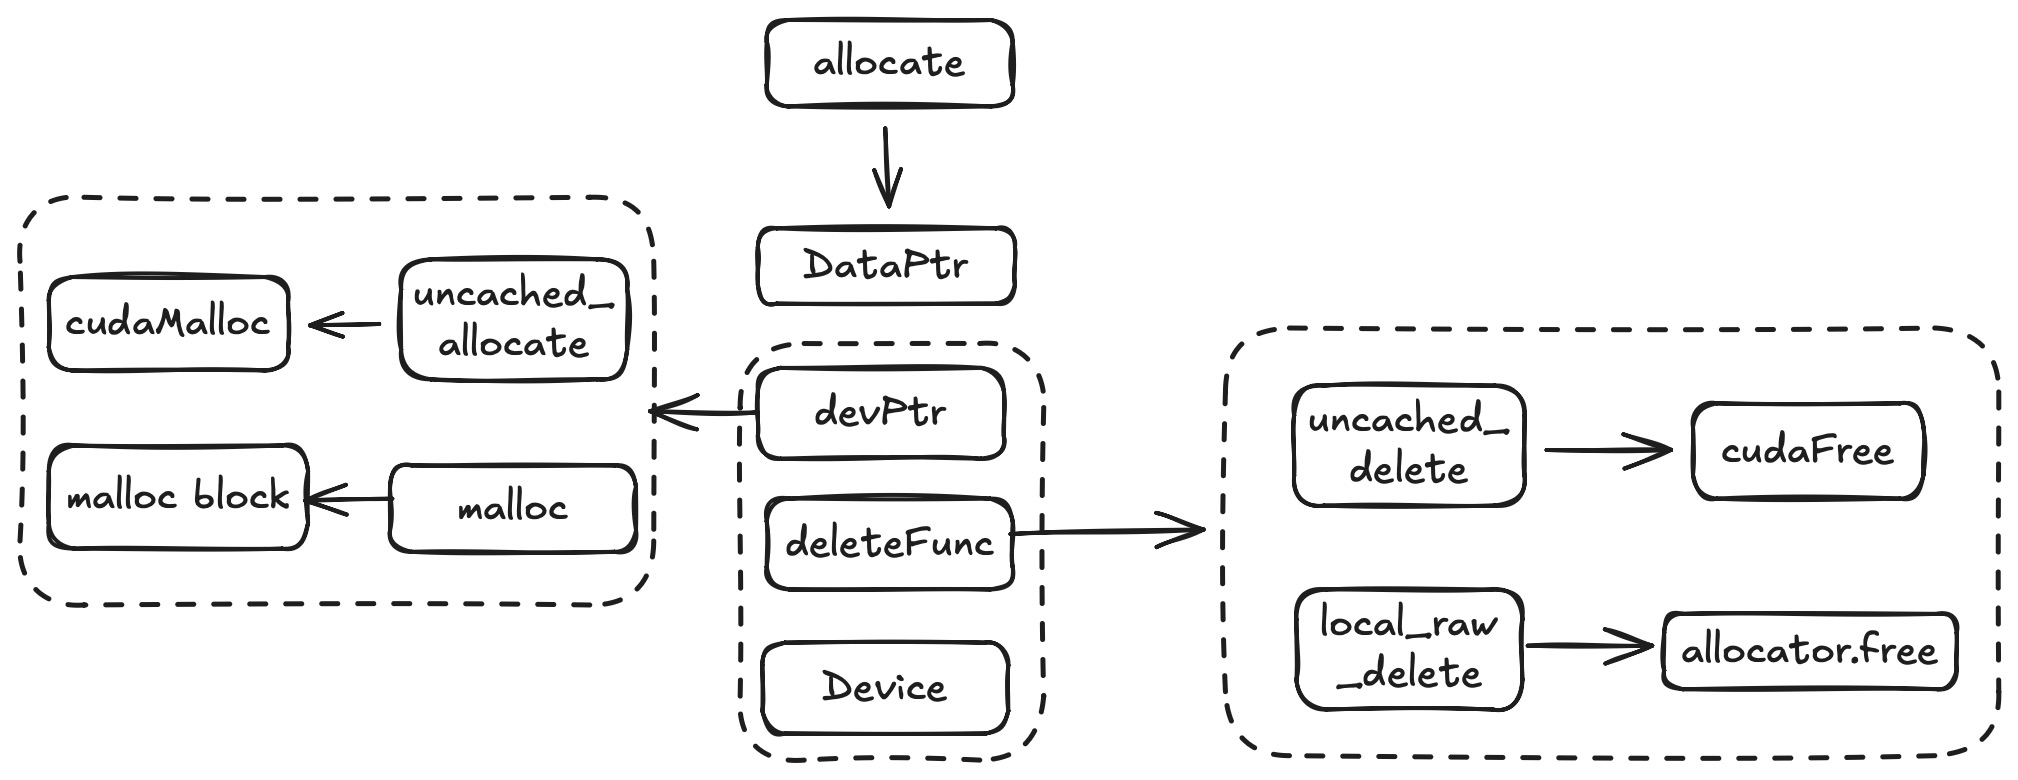
源码里看上去似乎只有在内存不足时才会清理缓存,那显然是不合理的,tensor和block的生命周期之间一定可以自动管理,而无需手动介入。实际上,这里是通过Tensor的Data_Ptr绑定实现的,当Tensor尝试malloc一块空间时,对应的deleteFunc也被写入了DataPtr中。一旦一个Tensor的引用计数归零,在析构时,就会连同对应的Block一块释放。如这张图所示:
free流程
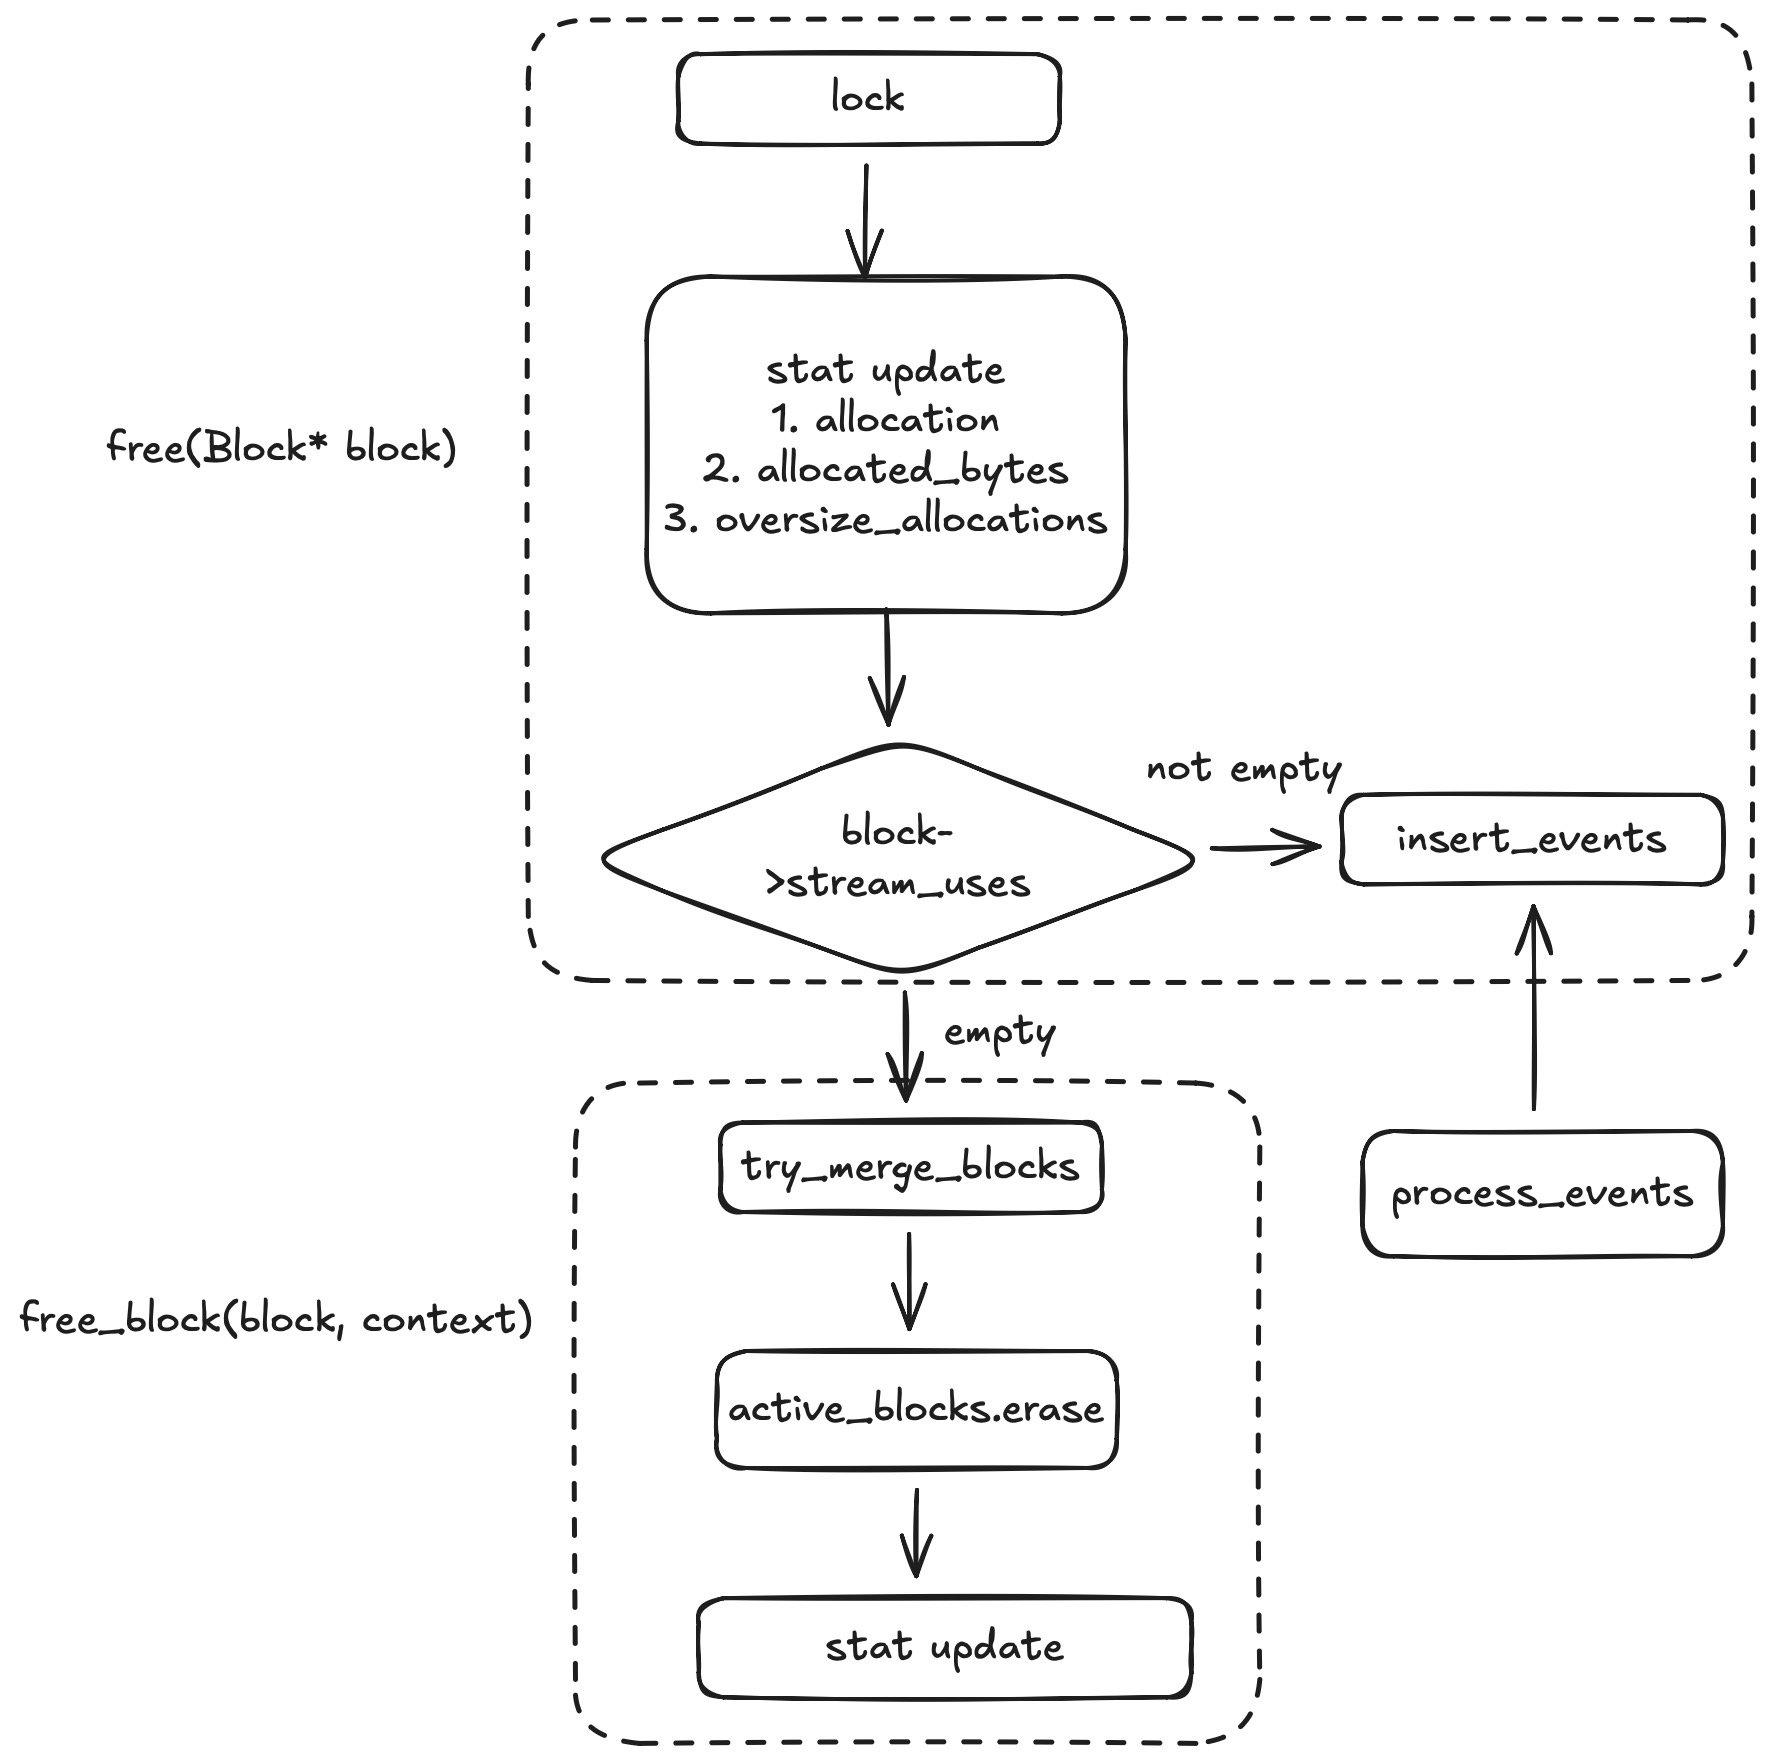
当尝试free一个block时,主要是更新一下状态,如引用计数等。针对cuda_graph、record_stream会有一些特殊的操作,以保证对应的block在正确的时机被释放,具体可以参考我关于record_stream的文章。此外,如果释放时block的左右邻居为空,则会尝试通过try_merge_block去将切分的block复原为一个完整的block,即归还。
补充
可以通过手动设定,来决定一个block释放可以被切分:
To further reduce fragmentation, blocks >= max_split_size are not allowed to be split. These oversize cached blocks will still satisfy requests within 1MB of the oversize cached block size. 通过
CUDAAllocatorConfig::max_split_size()设定一个值,大于这个值的不会被切分,通过这个可以手动控制一些block的释放。
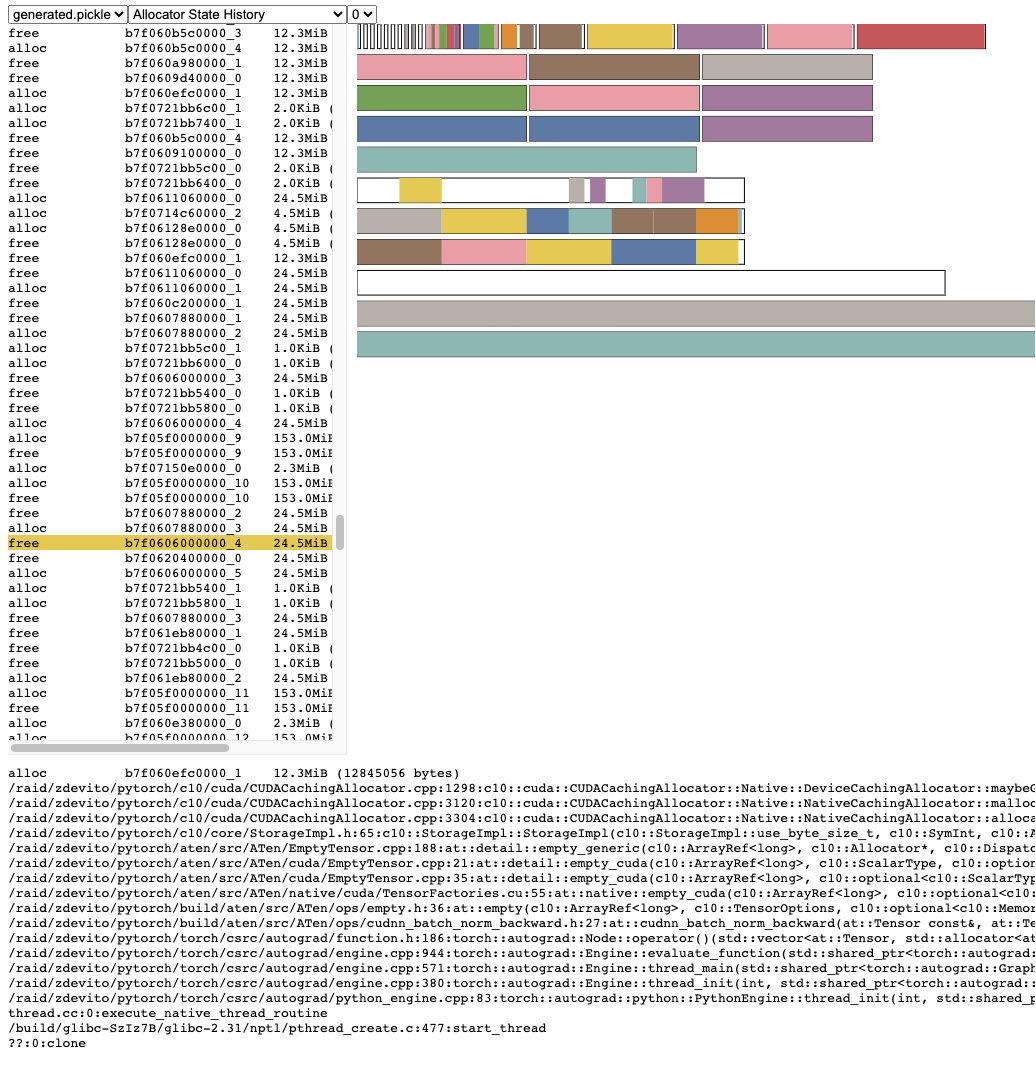
PyTorch官方有一个工具,可以可视化显存占用,里面有一部分会把所有的block罗列出来,我觉得这将对理解Block更有帮助。参考:这个链接
以官方的一个例子,最上面的一排就是2MB的block,其他是目前的block状态:
2026新年快乐!