简介
PyTorch FSDP2 对比 FSDP1的升级上一篇文章梳理了FSDP2,于是顺着梳理下DTensor相关的内容。在DTensor出现之前,Pytorch 中的分布式张量主要依赖于 torch.distributed 模块下的DDP、 FSDP及第三方库如DeepSpeed、Megatron-LM 提供的并行能力。使用这些框架往往需要在代码中不断地插入通信(如all-gather、all-reduce等),有了DTensor,降低用户手动管理通信操作的成本,进一步提高易用性,也是与torch的理念相匹配的。
DTensor基本用法
基本属性
DTensor是torch.Tensor的子类,因此可以像普通tensor一样操作它。DTensor通过DeviceMesh建立各个rank之间的关系,并通过Placement描述当前的状态,主要有三个Placement:Shard、Replicate和Partial
Replicate:每个rank拥有相同的完整参数;
Shard:每个rank只持有部份分块后的参数;
Partial:每个rank只持有部份数据,目前是等待all-reduce状态
三个属性之间的转换关系:
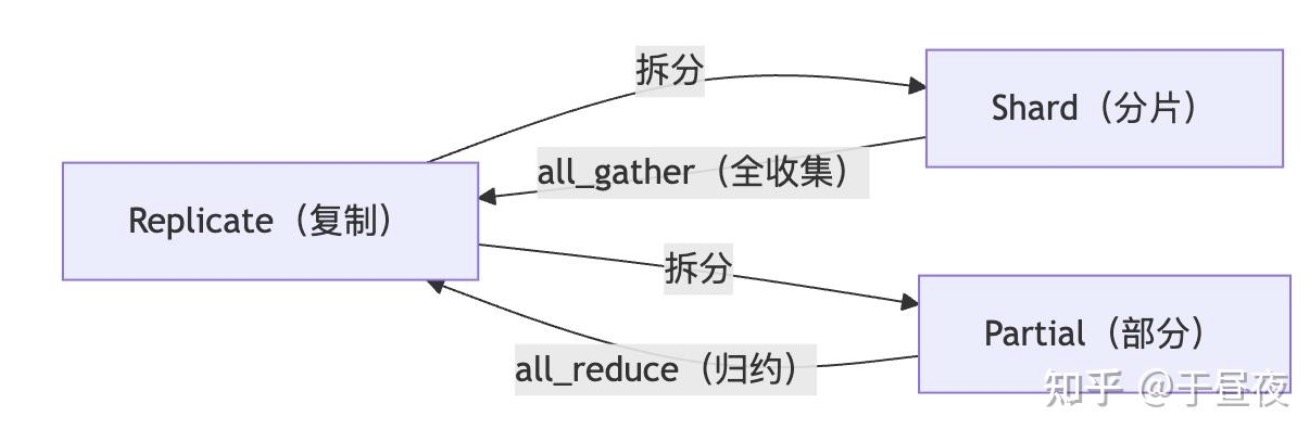
torch官方罗列了几个转换关系:
Shard(dim) -> Replicate(): all_gather
Shard(src_dim) -> Shard(dst_dim): all_to_all
Replicate() -> Shard(dim): local chunking (i.e. torch.chunk)
Partial() -> Replicate(): all_reduce
Partial() -> Shard(dim): reduce_scatter
API:
一个DTensor可以由如下API创建:
distribute_tensor()接口
local_tensor = torch.randn(8, 16, device=f"cuda:{rank}")

dtensor_shard = distribute_tensor(
    local_tensor,
    device_mesh=mesh,
    placements=[Shard(0)],
)
from local tensor
local_tensor = torch.tensor([[1, 2], [3, 4]])
dtensor_shard = DTensor(
    local_tensor,
    device_mesh=dist.DeviceMesh("cuda", list(range(world_size))),
    placements=[dist.Placement("shard", dim=0)]  # 沿第0维分片
)
或者
local_tensor = torch.tensor([1, 2, 3])
dtensor = local_tensor.to_dtensor(
    device_mesh=dist.DeviceMesh("cuda", [0,1]),
    placements=[dist.Placement("replicate")]
)
- 工厂函数
dtensor_ones = DTensor.ones(
    (2, 4),
    device_mesh=dist.DeviceMesh("cuda", list(range(world_size))),
    placements=[dist.Placement("shard", dim=1)]
)
创建好DTensor之后,就可以把DTensor当作普通的Tensor对象去操作和运算,DTensor会为你在必要时插入所需要的通信操作。
原理
一个携带DTensor的算子调用时,会先被DTensor中定义的__torch_dispatch__给Hook住,优先执行DTensor定义的Dispatch内的逻辑;
   def __torch_dispatch__(cls, func, types, args=(), kwargs=None):  # type: ignore[override]
       return DTensor._op_dispatcher.dispatch(
           func,
           args,
           kwargs or {},
       )
进入Dispather后,通过这行代码解包出op_info,包含device_mesh、_local_tensor、_spec等分布式信息
op_info = self.unwrap_to_op_info(op_call, args, kwargs)
基于分布式信息,推导shard规则,即以当前输入,输出的placement会是什么,这个推导有一定的优先级,源码中是这样描述的:
        Main dispatching logic.  Follows precedence order:
        (1) custom_op_handler
        (2) registered sharding strategy, then rule
        (3) composite implicit autograd decomposition
除了自定义handler,优先级是strategy然后是rule,取决于算子的分布式注册方法,如果没有则尝试回退到composite实现。
pytorch通过@register_op_strategy注册生成的是strategy,会计算通信cost,优先级更高,通过@register_prop_rule注册的是rule,优先级较低。
基于分布式信息和placement进行计算,并在计算前完成相应的通信操作,如all-gather等。在完成计算后,会根据是否仅保留local_tensor再次进行相应的通信操作。
题外话
为什么__torch_dispatch__可以实现hook,在DTensor执行前顺利接管?
pytorch会check输入的对象中是否有__torch_dispatch__这个attr
static bool check_has_torch_dispatch(PyObject* obj) {
  PyTypeObject* tp = Py_TYPE(obj);
  if (THPVariable_CheckTypeExact(tp)) {
    return false;
  }
  py::object attr = PyObject_FastGetAttrString(obj, "__torch_dispatch__");
  return (
      attr.ptr() != nullptr &&
      attr.ptr() != torch::disabled_torch_dispatch_impl());
}
如果有就会尝试去为其增加python这个dispatch key
      if (has_torch_dispatch_if_known.has_value()
              ? *has_torch_dispatch_if_known
              : check_has_torch_dispatch(obj)) {
        var.unsafeGetTensorImpl()->set_python_dispatch(true);
而python key的优先级比cuda等dence key的优先级更高,会先被调用,因此可以实现这个hook 挖个坑🕳️,后面有空梳理下Dispatch优先级的内容
Reference
https://docs.pytorch.org/docs/stable/distributed.tensor.html